Nén token cho AI agent bằng Headroom: chạy thử giảm 54% token
Mình cài Headroom trên Windows và chạy thử nén log JSON: 13.226 token còn 6.045 trong khoảng 5 giây, không cần GPU hay khoá API. Bài kể lệnh đã chạy và các hạn chế.
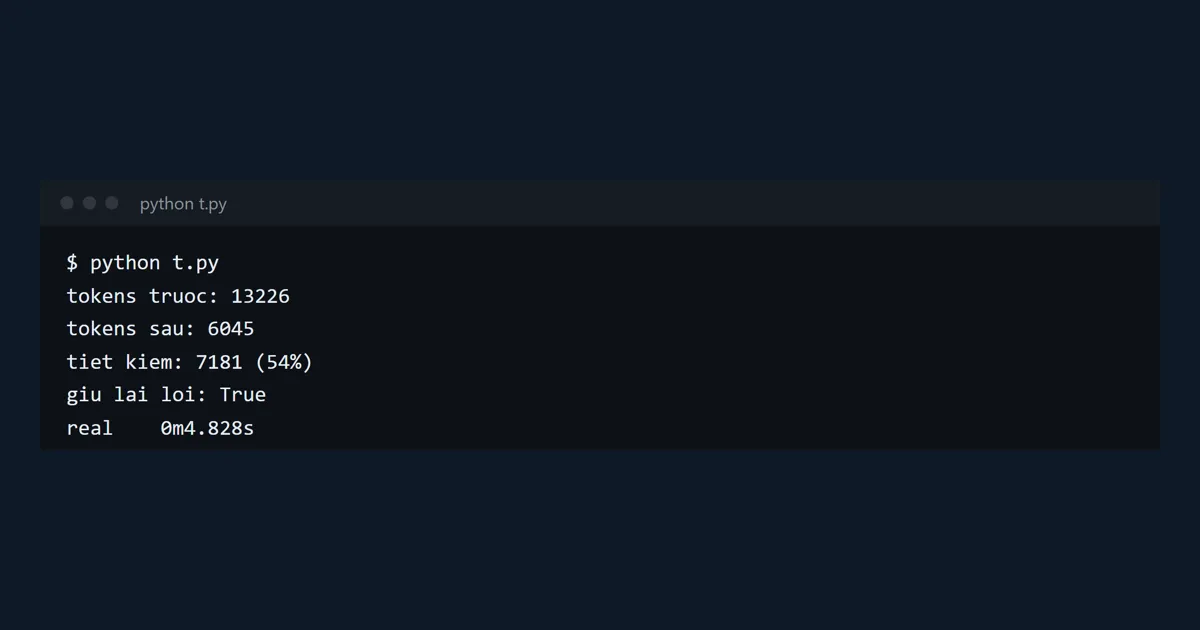
Nén token cho AI agent là việc làm gọn dữ liệu (log, JSON, kết quả công cụ) trước khi gửi cho mô hình, để trả ít tiền hơn cho mỗi lượt gọi. Headroom là một công cụ mã nguồn mở làm đúng việc này, và mình đã cài rồi chạy thử trên máy Windows, không cần GPU, không cần khoá API.
Một mẫu thử: 13.226 token còn 6.045 token, trong khoảng 5 giây. Bài này kể lại lệnh đã chạy, con số thật, và những chỗ bạn nên thận trọng trước khi tin vào các con số quảng cáo.
Tóm tắt nhanh
- Thông tin xem ngày 07/10/2026, từ README chính thức của Headroom trên GitHub.
- Giấy phép Apache 2.0, cài bằng pip, có thể dùng như thư viện Python, proxy hoặc bọc quanh một coding agent.
- Mình tự chạy thư viện bản lõi: cài mất 1 phút 19 giây, nén một mẫu JSON 300 đơn hàng giảm 54% token.
- Điều này phù hợp với người đang xây agent xử lý nhiều log và dữ liệu có cấu trúc, ít phù hợp với chatbot hỏi đáp ngắn.
- Chưa kiểm chứng: các con số "60-95% với JSON" của tác giả, chế độ proxy và
headroom wrap, chất lượng câu trả lời của mô hình sau khi nén trên dữ liệu thật của bạn.
Headroom AI là gì và giải quyết vấn đề nào
Theo README của Headroom, đây là lớp tối ưu context đặt giữa ứng dụng và mô hình ngôn ngữ. Nó nén kết quả của công cụ, log, đoạn RAG và file trước khi chúng vào context của LLM. Tác giả nêu mục tiêu khoảng 20% token ít hơn với coding agent và 60-95% ít hơn với JSON, mà câu trả lời vẫn giữ nguyên. Đây là con số của tác giả, mình chưa tự kiểm chứng.
Vấn đề thật sự rất quen với ai từng chạy agent lâu: mỗi lượt gọi tool trả về một cục dữ liệu lớn, cục đó nằm lại trong context của cuộc trò chuyện và bị tính tiền lại ở mọi lượt sau. Một báo cáo đơn hàng 300 dòng, mỗi dòng gần như giống nhau, vẫn được gửi nguyên cho mô hình đọc.
Headroom AI đánh vào chính chỗ lặp đó. Nó nhận ra loại nội dung (JSON, log, code, văn bản) rồi dùng cách nén phù hợp từng loại, thay vì cắt cụt một cách mù quáng. Với người làm nội dung và bán hàng, ý nghĩa dễ hiểu: cùng một ngân sách, agent của bạn đọc được nhiều dữ liệu hơn hoặc hoá đơn thấp hơn.
Cách nén ngữ cảnh LLM hoạt động, nói bằng ví dụ đời thường
Hãy hình dung bạn nhờ trợ lý đọc một bảng Excel 300 dòng để tìm đơn bị lỗi. Nếu 299 dòng ghi "đã giao, Hà Nội, thành công", trợ lý chỉ cần biết "299 dòng giống nhau theo mẫu này" và đọc kỹ dòng khác lạ. Nén ngữ cảnh LLM (tức là nén context) theo tinh thần đó: giữ phần mang thông tin, rút gọn phần lặp.
README mô tả ba cách sử dụng. Một là headroom deploy, dựng sẵn proxy cục bộ. Hai là headroom wrap claude, bọc quanh một coding agent. Ba là headroom proxy --port 8787, chạy như proxy thay thế mà không phải sửa code ứng dụng. Mình chỉ thử cách sử dụng thư viện Python, vì nó chạy được ngay mà không cần tài khoản hay khoá của nhà cung cấp mô hình.
Điều đáng chú ý là nó nằm ngoài mô hình: bạn không đổi mô hình, không đổi prompt, chỉ đổi dữ liệu đi qua. Vì thế bạn có thể đo trước rồi quyết định có dùng hay không.
Chạy thử thực tế: cài đặt trong 1 phút 19 giây
Mình tạo môi trường ảo Python mới và cài bản lõi, không kèm các phần mở rộng [all] của README, để thử nhanh:
python -m venv v./v/Scripts/pip install headroom-aiCài xong sau 1 phút 19 giây trên máy Windows 10, không báo lỗi. Gói kéo theo khá nhiều thư viện nên thời gian phụ thuộc đường mạng của bạn.
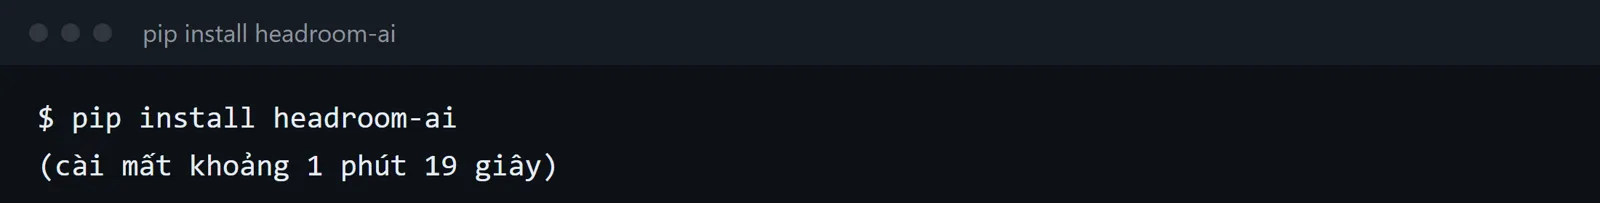
Ảnh trên là ảnh chụp từ terminal của máy chạy thử, ghi lại lệnh cài và thời gian cài. Sau đó mình chạy headroom --help và thấy danh sách lệnh như proxy, dashboard, doctor, inspect, deploy.
Lúc import thư viện, Headroom in một dòng cảnh báo trên Windows: bộ nhận diện nội dung gốc (Magika/ONNX) bị tắt vì không an toàn mặc định, nên nó dùng bản Python thuần. Nó vẫn chạy bình thường, nhưng đây là điều bạn nên biết nếu thấy tốc độ chậm hơn trên Linux.
Nén log JSON: 13.226 token còn 6.045
Để thử cho thật, mình tự tạo dữ liệu mô phỏng báo cáo 300 đơn hàng, mỗi dòng có mã, trạng thái, thành phố, giá và ghi chú. Trong 300 dòng đó mình cố ý đổi một dòng thành "LOI THANH TOAN" để xem phần nén có làm mất dòng bất thường không. Đoạn code sử dụng đúng hàm compress như README:
import jsonfrom headroom import compressmessages = [ {"role": "user", "content": "Tim don loi trong du lieu nay"}, {"role": "tool", "tool_call_id": "c1", "content": json.dumps(rows, ensure_ascii=False)},]r = compress(messages, model="gpt-4o")print(r.tokens_before, r.tokens_after, r.tokens_saved)Số đo nằm trong ảnh dưới đây. Nén log JSON kiểu này giảm từ 13.226 xuống 6.045 token, tiết kiệm 7.181 token, tương đương 54%, và dòng lỗi vẫn còn nguyên trong kết quả. Toàn bộ chạy trong khoảng 4,8 giây, trên CPU, không gọi tới mô hình nào.
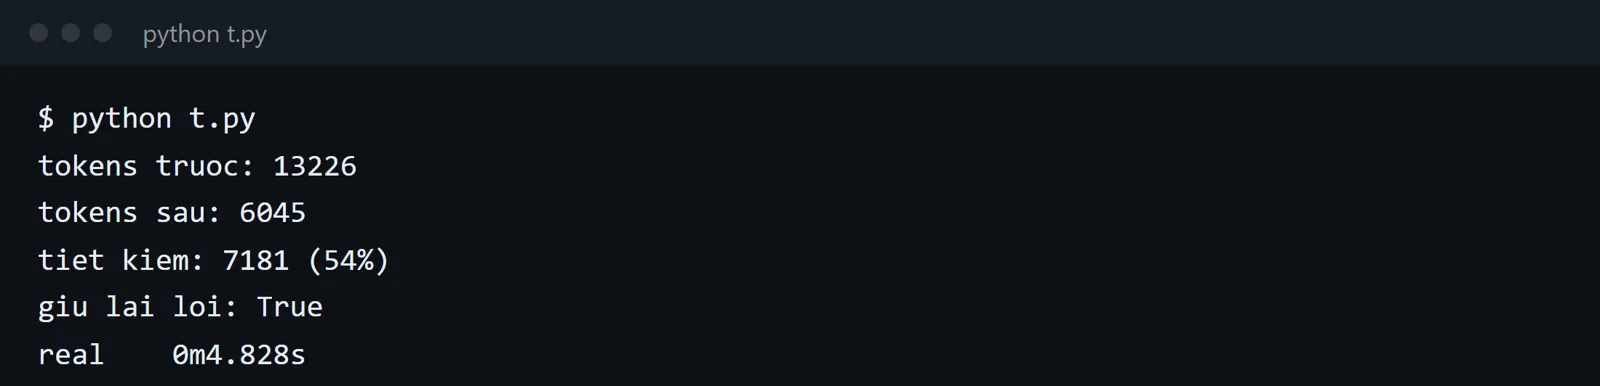
Ảnh cho thấy bốn dòng kết quả: số token trước, sau, số token tiết kiệm và việc dòng lỗi được giữ lại. Lưu ý quan trọng: đây là dữ liệu tự tạo, lặp rất nhiều, nên đúng loại dễ nén. Con số 54% của mình thấp hơn khoảng 60-95% trong README, và bạn không nên suy ra rằng dữ liệu của mình sẽ cho kết quả tương tự. Hãy đo trên log thật của bạn.
Đo hiệu quả nén token cho AI agent trên hệ thống của bạn
Kỹ thuật nén chỉ đáng sử dụng khi nó cho số đo rõ ràng trên chính hệ thống của bạn. Cách làm gọn: lấy 20-50 lượt gọi tool thật từ log của agent, chạy từng lượt qua compress, ghi lại số token trước và sau. Đây là việc xử lý offline, không đụng tới người dùng cuối hay hệ thống đang chạy.
Sau đó hỏi mô hình cùng một câu hỏi với context gốc và context đã nén, rồi so sánh đáp án. Với tác vụ tra cứu như "đơn nào bị lỗi", bạn dễ kiểm tra đúng sai. Với tác vụ phức tạp hơn như phân tích xu hướng doanh số, hãy kiểm tra kỹ hơn, vì một con số bị rút gọn có thể làm đổi kết luận.
Nếu cả hai bước đều ổn, bạn mới nghĩ tới chế độ proxy để áp dụng cho toàn bộ agent. Ví dụ, một shop có agent tra cứu đơn mỗi ngày nên bắt đầu bằng một tác vụ, đo trong một tuần, rồi mới mở rộng sang các tác vụ khác. Cách đi chậm này tốn thêm vài giờ nhưng tránh được rủi ro cả hệ thống trả lời sai mà không ai biết.
Giảm chi phí token: nên áp dụng cho việc gì
Giảm chi phí token có ý nghĩa khi agent của bạn lặp lại nhiều lượt trên dữ liệu có cấu trúc. Vài tình huống hợp lý cho doanh nghiệp Việt:
- Agent đọc báo cáo bán hàng, danh sách đơn từ API của sàn hoặc CRM, nơi mỗi dòng có cùng các trường.
- Agent hỗ trợ khách hàng phải đọc lịch sử đơn và log vận chuyển dài.
- Agent chạy lệnh trong terminal rồi nhận về log build hoặc log lỗi hàng nghìn dòng.
- Quy trình RAG nội bộ trả về nhiều đoạn tài liệu gần giống nhau.
Nếu bạn dùng mô hình tính phí theo token, mỗi phần trăm giảm được nhân với số lượt gọi trong tháng. Trước khi triển khai, hãy đo trên một mẫu 20-50 lượt thật, so sánh câu trả lời trước và sau khi nén, rồi mới nhân lên.
Những hạn chế cần nói thẳng
Một là, README tự nói rằng với hội thoại ngắn hoặc văn xuôi đã cô đọng, mức giảm rất ít hoặc không có. Nếu agent của bạn chủ yếu chat qua lại bằng câu ngắn, công cụ này gần như không giúp được gì.
Hai là, mình chỉ đo số token, chưa đo chất lượng câu trả lời của mô hình sau khi nén. Việc giữ lại một dòng lỗi trong mẫu thử không chứng minh rằng mọi chi tiết quan trọng đều được giữ trong dữ liệu thật của bạn.
Ba là, mình chưa thử chế độ proxy, headroom wrap và dashboard, nên không thể nói chúng ổn định ra sao. Bốn là, trên Windows thư viện đang dùng bộ nhận diện nội dung bằng Python thuần. Các điểm này là lý do nên thử trong môi trường nháp trước.
Ý nghĩa với người làm nội dung và bán hàng
Nếu bạn đang xây agent để tự động hoá việc viết nội dung, tra cứu đơn hàng hay trả lời khách, chi phí token thường là khoản tăng đều mà ít người theo dõi. Một công cụ mã nguồn mở nén context, chạy được trên máy thường, đáng để thử vì chi phí thử rất thấp: một lệnh cài và một đoạn code ngắn.
Nếu bạn quan tâm đến cách tổ chức môi trường làm việc cho agent, bài Harness Engineering: bộ công cụ tối ưu cho kỹ sư AI là điểm bắt đầu hợp lý. Còn nếu bạn muốn xem thêm những công cụ khác cùng thời điểm, đọc tổng hợp công cụ và mã nguồn đáng chú ý tuần này.
Kết luận
Headroom là công cụ đáng thử cho người đang chạy agent trên dữ liệu lặp và có cấu trúc. Chỉ cần một buổi chiều là bạn có số đo thật: mẫu của mình giảm 54% token và vẫn giữ dòng lỗi.
Điều người dùng cần nhớ là con số trong README và con số của mình đều chưa nói gì về dữ liệu của bạn. Hãy chạy thử trong môi trường nháp, nơi người dùng thật chưa bị ảnh hưởng, so sánh đáp án trước và sau, rồi mới quyết định nén token cho AI agent ở quy mô lớn.
Nếu thử xong, bạn có thể chia sẻ lại con số của mình cho cộng đồng làm nội dung và bán hàng. Số đo thật từ nhiều loại dữ liệu khác nhau sẽ có ích hơn mọi lời quảng cáo, và giúp người đến sau chọn đúng cách nén token cho AI agent.