Cào dữ liệu web bằng AI với Crawl4AI: chạy thử trên Windows, lấy 44 bài thành bảng trong 1 giây
Mình cài Crawl4AI trên Windows, đổi trang web sang Markdown trong 9 giây, lấy 44 bài thành bảng bằng CSS trong 1,1 giây và thử trích bằng Gemini mất 169,5 giây. Kèm việc doanh nghiệp làm được và rủi ro cần biết.
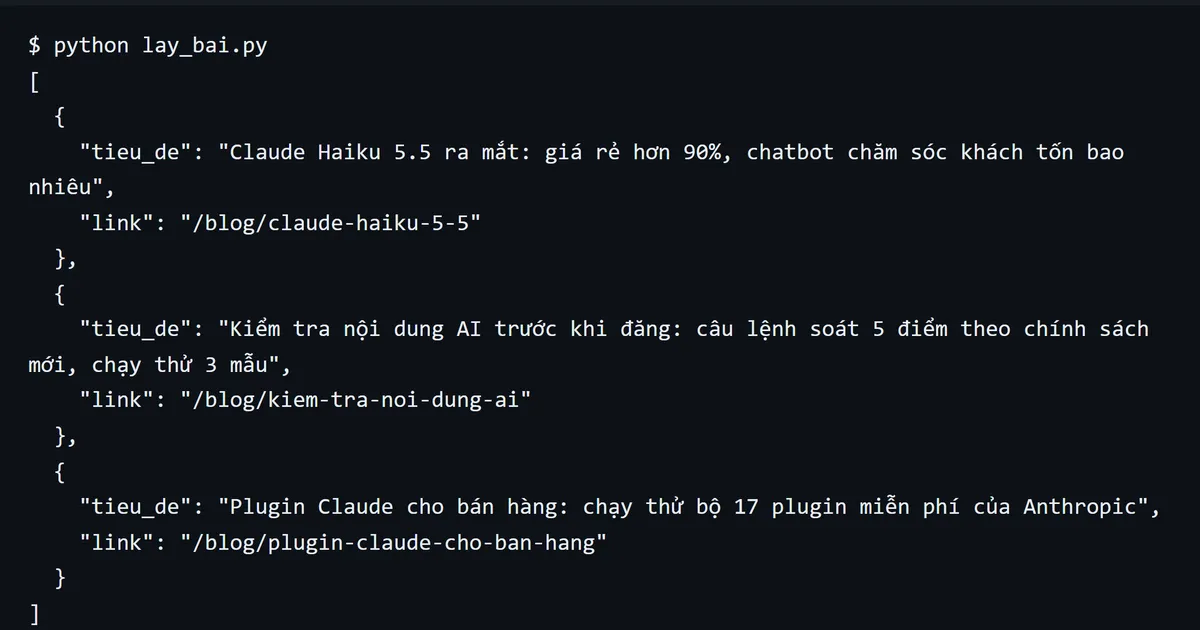
Cào dữ liệu web bằng AI giúp bạn bỏ việc mỗi sáng mở mười trang web để chép tay giá, tiêu đề, khuyến mãi vào bảng tính, việc ai làm bán hàng cũng từng gặp. Bài này hướng dẫn tự động hóa việc đó với Crawl4AI, một công cụ miễn phí chạy ngay trên máy tính văn phòng: mình đã cài và chạy thử trên Windows, lấy 44 tiêu đề bài viết thành bảng chỉ trong khoảng 1 giây.
Bài ghi rõ từng lệnh, mất bao lâu, ra kết quả gì, chỗ nào lỗi, và cả những điều cần cẩn thận trước khi dùng cho việc kinh doanh.
Tóm tắt nhanh
- Crawl4AI là thư viện Python mã nguồn mở, giấy phép Apache-2.0, bản 0.9.4 ra ngày 23/9/2026 (theo GitHub và PyPI, xem ngày 10/10/2026).
- Cài mất khoảng 2 phút rưỡi trên máy mình: 98 giây cho
pip install, 58 giây cho bước tải trình duyệt. - Chuyển trang web sang Markdown mất 9 giây. Trích danh sách 44 bài thành JSON bằng bộ chọn CSS mất 1,1 giây và không cần khoá AI nào.
- Trích bằng AI (Gemini, khoá miễn phí) chạy được nhưng mất 169,5 giây, và tên model cũ đã bị Google ngừng.
- Chưa kiểm chứng: hiệu quả với trang có chống bot mạnh, và chế độ chạy nhiều trang cùng lúc.
Crawl4AI là gì và vì sao đáng để ý
Crawl4AI là gì? Đây là một trình quét web (web crawler) viết bằng Python, do cộng đồng phát triển công khai trên kho GitHub của Crawl4AI với hơn 80 nghìn sao lúc mình xem. Việc của nó rất đơn giản: tự động mở một trang web bằng trình duyệt thật, đợi trang tải xong, rồi trích xuất phần nội dung dưới dạng chữ sạch hoặc dữ liệu có cấu trúc. Nó không phải một nền tảng trả phí theo tháng, mà là thư viện bạn tích hợp thẳng vào đoạn code tự động hóa của mình.
Điểm khác với nhiều công cụ cào dữ liệu khác là nó được xây dựng để đưa kết quả cho AI đọc. Thay vì trả về mã HTML lộn xộn (HTML là "bộ khung" của trang web, chứa cả menu, quảng cáo, mã theo dõi), nó trả về Markdown, một kiểu văn bản có tiêu đề, danh sách, đường link rõ ràng mà các mô hình ngôn ngữ lớn (LLM, tức AI kiểu ChatGPT, Claude, Gemini) đọc rất dễ.
Cứ hình dung thế này: bạn thuê một trợ lý mở từng trang web, chép phần chữ quan trọng vào sổ, bỏ qua banner và menu. Hệ quả thực tế là khi đưa cuốn sổ đó cho AI tóm tắt, AI đọc ít chữ thừa hơn nên trả lời đúng trọng tâm hơn và tốn ít lượt gọi hơn.
Với doanh nghiệp nhỏ, lý do đáng để ý là chi phí và khả năng tự động xử lý nhiều trang mỗi ngày. Đây là công cụ cào dữ liệu miễn phí, giấy phép Apache-2.0 cho phép dùng thương mại, chạy trên máy của bạn chứ không phải trả tiền theo lượt như các dịch vụ cào thuê.
Chạy thử thực tế: cài Crawl4AI trên Windows
Mình chạy trên Windows 10, Python 3.13, không có card đồ hoạ rời, trong một môi trường ảo (venv) riêng để không ảnh hưởng phần mềm khác. README yêu cầu Python từ 3.10 trở lên. Lệnh cài theo đúng hướng dẫn chính thức:
pip install -U crawl4aicrawl4ai-setupLệnh đầu mất 98 giây, cài đúng bản 0.9.4. Lệnh thứ hai mất 58 giây: nó tự tải Chrome for Testing (khoảng 196 MB) và một bản Chrome chạy ẩn (khoảng 115 MB), làm hai lượt cho hai chế độ Playwright và Patchright, rồi khởi tạo cơ sở dữ liệu lưu bộ nhớ đệm. Bạn nên chuẩn bị khoảng 300 MB trống và mạng ổn định.
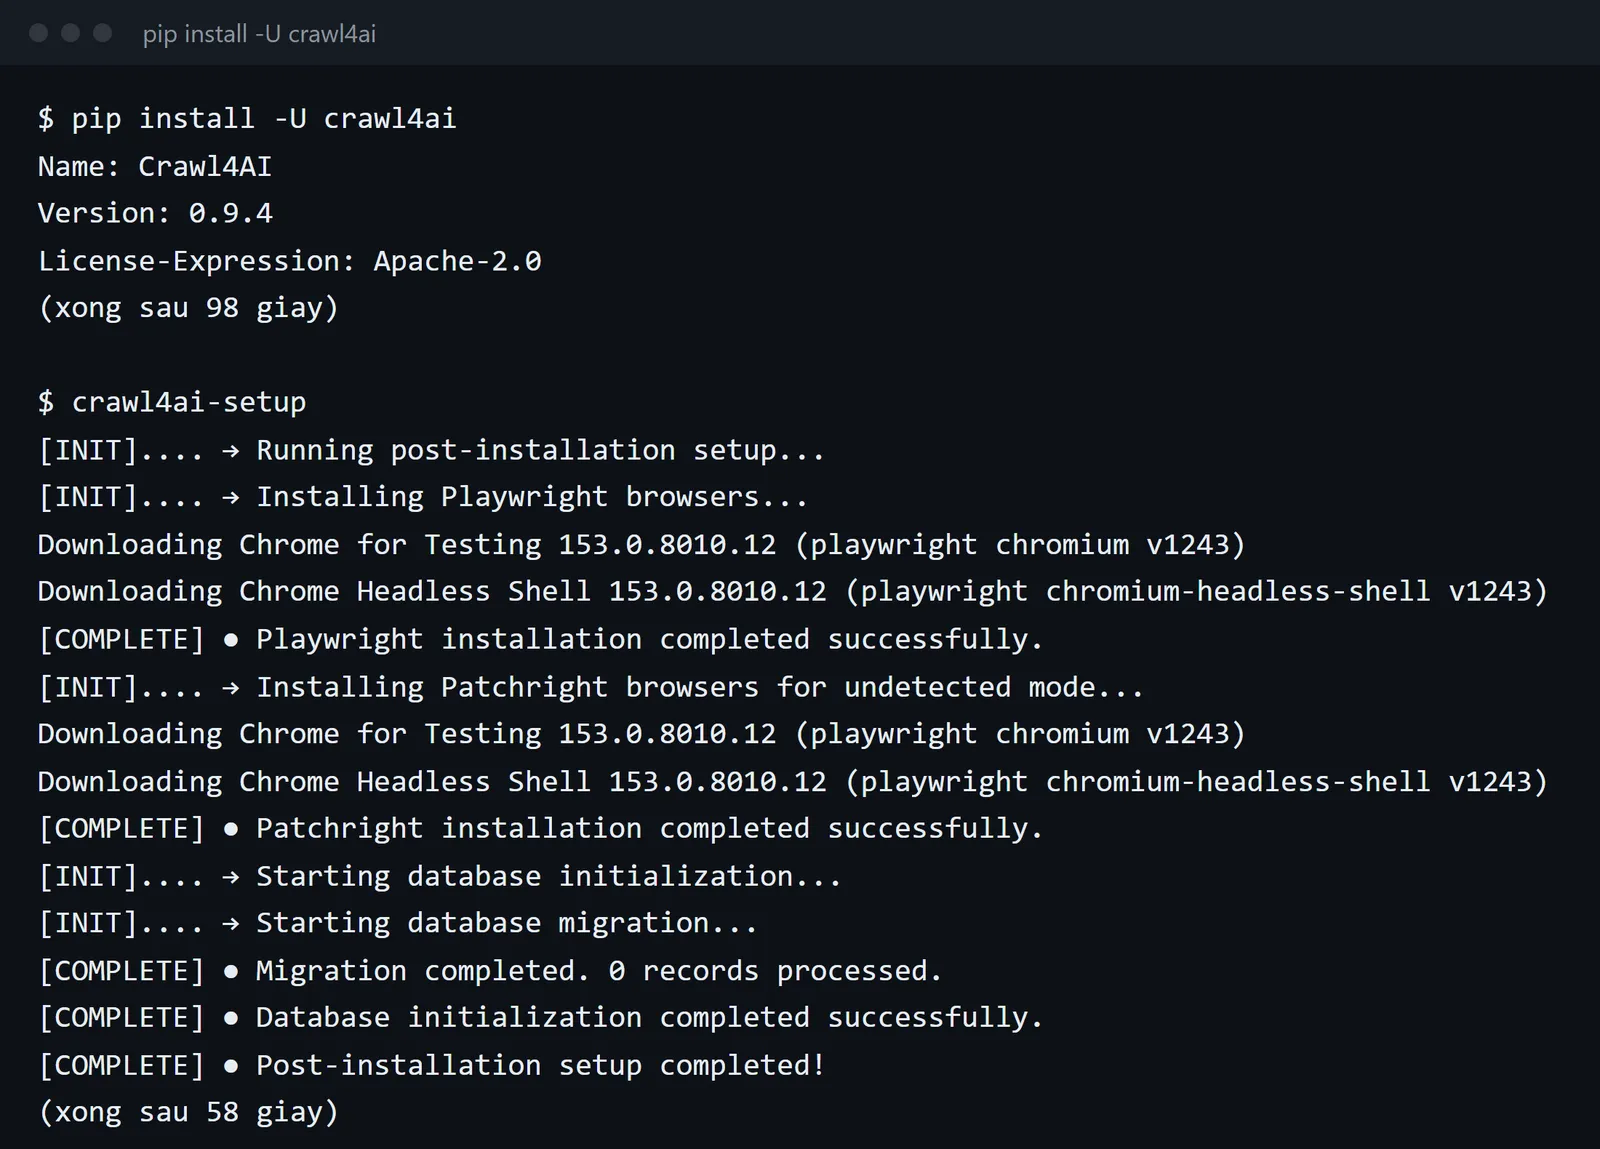
Ảnh trên là nguyên văn những dòng chính trong cửa sổ lệnh: tên gói Crawl4AI, phiên bản 0.9.4, giấy phép Apache-2.0, các dòng tải trình duyệt và dòng cuối "Post-installation setup completed!". Mình không gặp lỗi nào ở bước cài, chỉ có thông báo pip nên nâng cấp.
Chuyển trang web sang Markdown bằng một lệnh
Để thử bước chuyển trang web sang Markdown, mình dùng lệnh crwl đi kèm thư viện, chạy trên chính trang blog của Deman AI Lab (mình không cào trang của người khác trong bài thử này):
crwl https://www.demanlab.ai/blog -o markdownLệnh chạy 9 giây và trả về 332 dòng, khoảng 3.063 chữ. Phần đầu là menu của trang (Dịch vụ, Cửa hàng, Liên hệ), tiếp theo là từng bài viết với chủ đề, số phút đọc, tiêu đề dạng ## và đoạn mô tả.
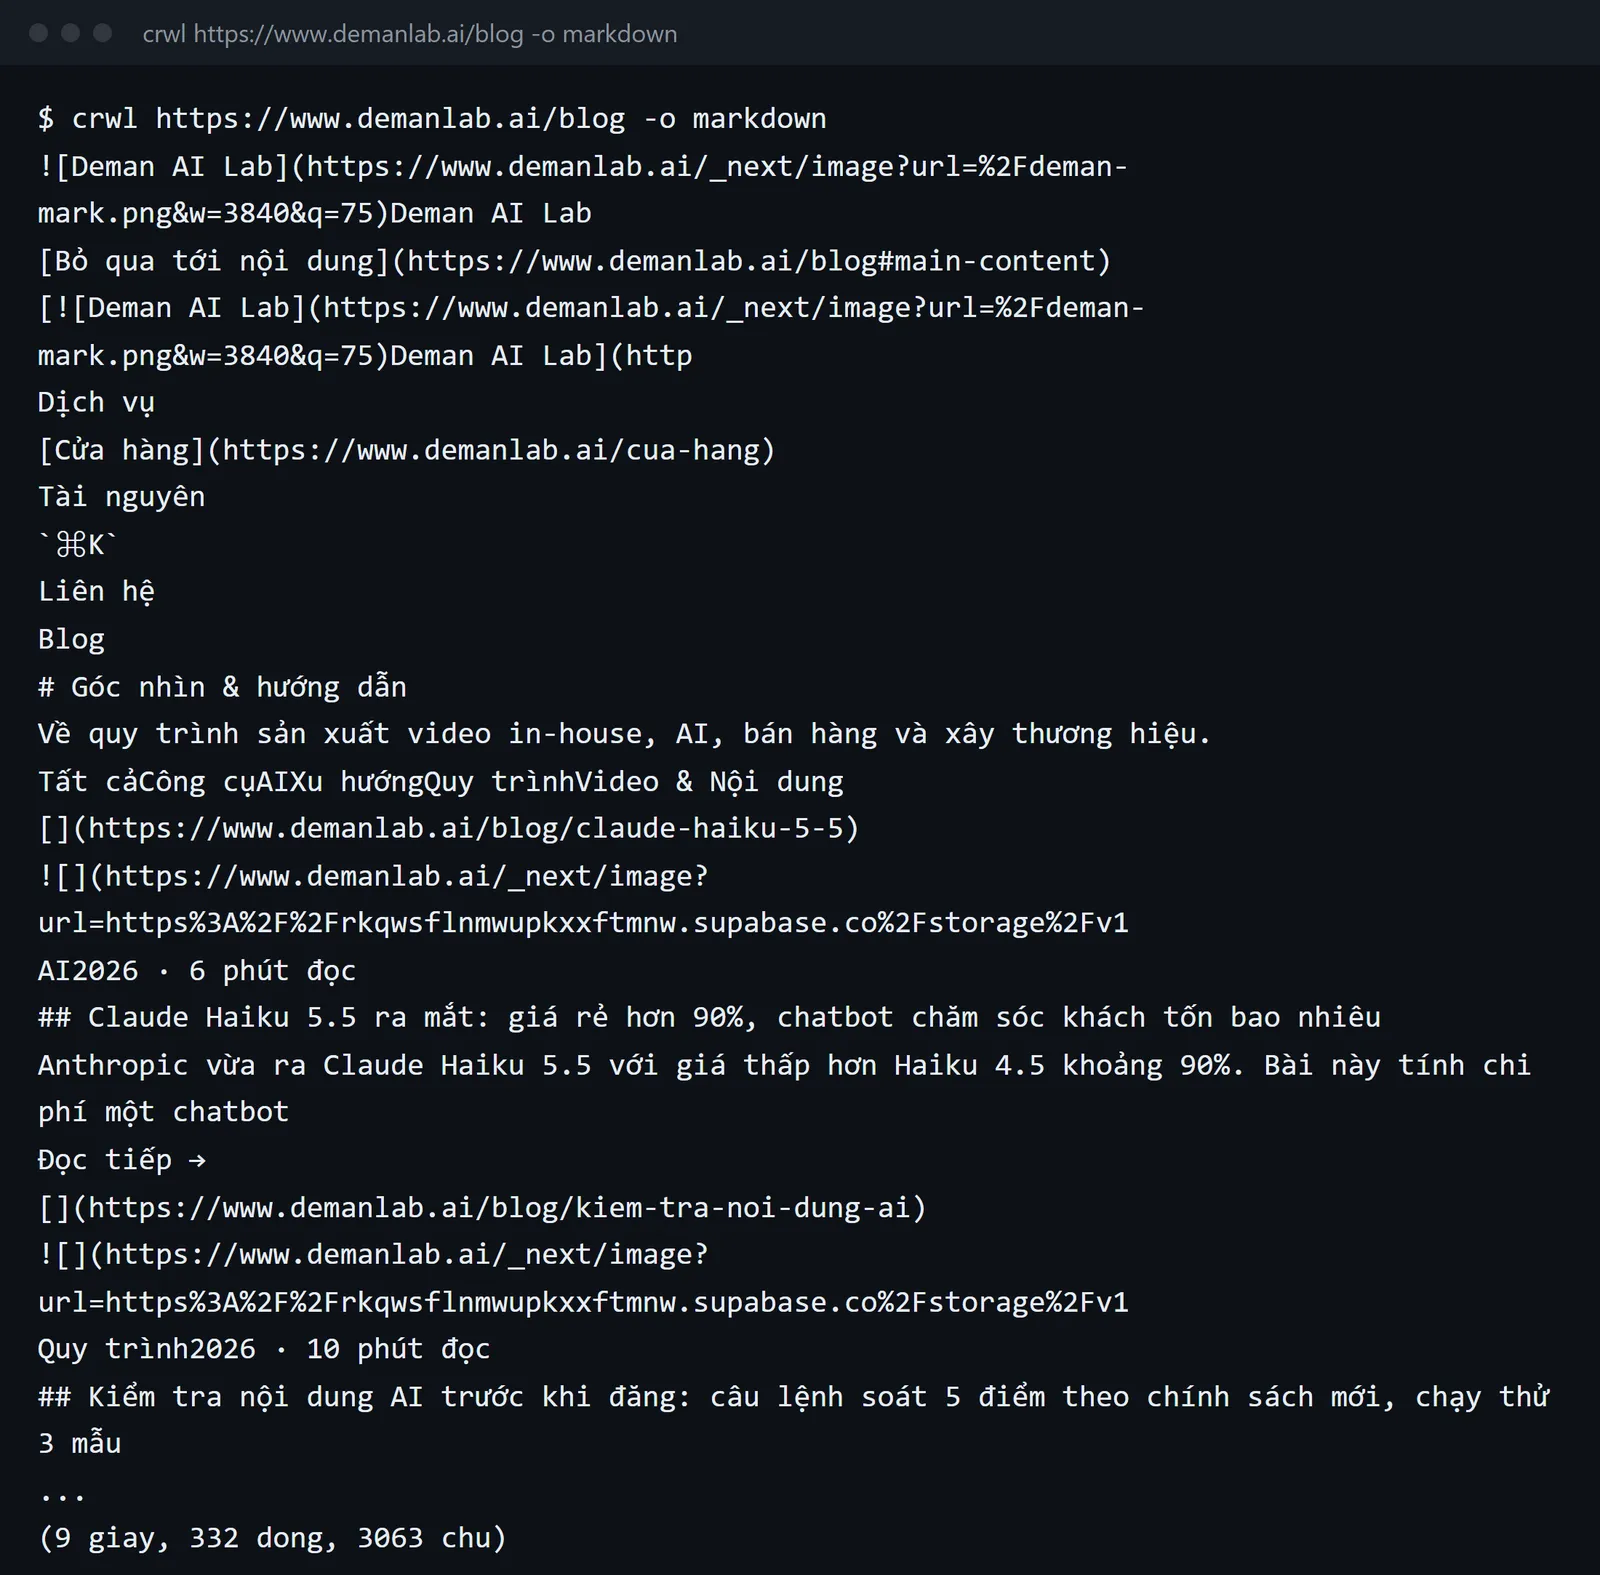
Kết quả đọc được ngay, nhưng chưa thật sạch với trang có bố cục phức tạp: vẫn còn menu và các đường link ảnh rất dài. README có nhắc tới bộ lọc "fit markdown" để bỏ phần thừa này, mình chưa thử nên chưa dám khẳng định nó lọc tốt tới đâu. Nếu chỉ cần đưa cả trang cho AI tóm tắt thì bản này đã dùng được.
Crawl dữ liệu website thành bảng không cần AI
Phần làm mình thích là crawl dữ liệu website thành bảng gọn mà không tốn đồng nào cho AI. Crawl4AI hỗ trợ trích xuất dữ liệu bằng bộ chọn CSS: bạn chỉ cho nó "mỗi bài viết nằm ở thẻ nào, tiêu đề nằm ở thuộc tính nào", nó lấy ra đúng các trường đó thành JSON (một dạng dữ liệu có cấu trúc, mở được bằng Excel hoặc Google Sheets sau khi chuyển đổi).
Đây là đoạn web scraping Python mình viết, phần chính chỉ khoảng 10 dòng:
schema = { "name": "bai_viet", "baseSelector": "a.absolute.inset-0[href^='/blog/']", "fields": [ {"name": "tieu_de", "type": "attribute", "attribute": "aria-label"}, {"name": "link", "type": "attribute", "attribute": "href"}, ],}cfg = CrawlerRunConfig(extraction_strategy=JsonCssExtractionStrategy(schema))async with AsyncWebCrawler() as crawler: r = await crawler.arun(url="https://www.demanlab.ai/blog", config=cfg)Kết quả: 44 bài, mỗi bài có tiêu đề và đường link, mất 1,1 giây. Lưu ý đây là lần chạy thứ hai trên cùng trang nên trình duyệt đã khởi động sẵn; lần đầu sẽ chậm hơn vài giây.
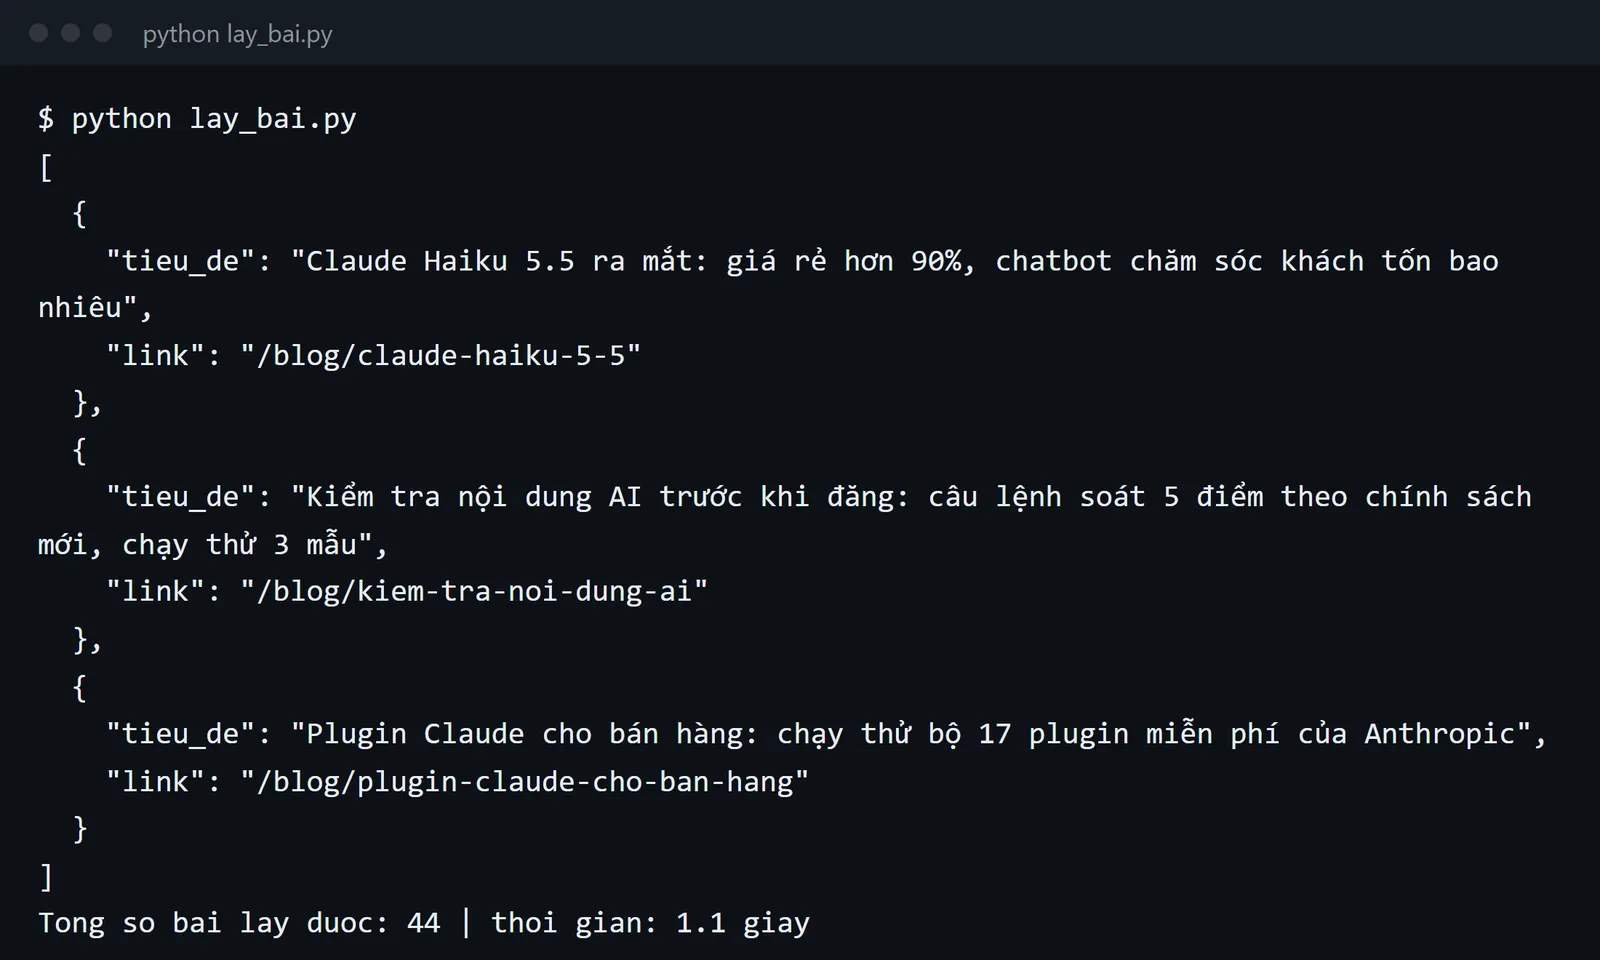
Cách CSS giống cái khuôn cắt bánh: đặt khuôn đúng chỗ là cắt ra đúng miếng, nhanh và không tốn tiền. Đổi lại, khi trang web đổi giao diện thì khuôn lệch, bạn phải sửa lại bộ chọn. Với trang bạn theo dõi thường xuyên, mỗi lần sửa chỉ vài phút.
Cào dữ liệu web bằng AI: hỏi bằng câu lệnh, chậm hơn nhiều
Cách thứ ba là để AI tự đọc trang và trích xuất theo yêu cầu bằng lời, rất hợp khi bạn chưa biết cấu trúc trang. Crawl4AI gọi AI qua thư viện LiteLLM nên dùng được nhiều nhà cung cấp; mình dùng khoá Gemini gói miễn phí sẵn có, câu lệnh là "liệt kê 5 bài viết mới, tiêu đề, chủ đề, số phút đọc".
Lần đầu mình ghi model gemini/gemini-2.5-flash thì nhận lỗi 404, Google báo model này không còn mở cho người dùng mới và gợi ý chuyển sang gemini-3.8-flash. Đổi tên model xong thì chạy được.
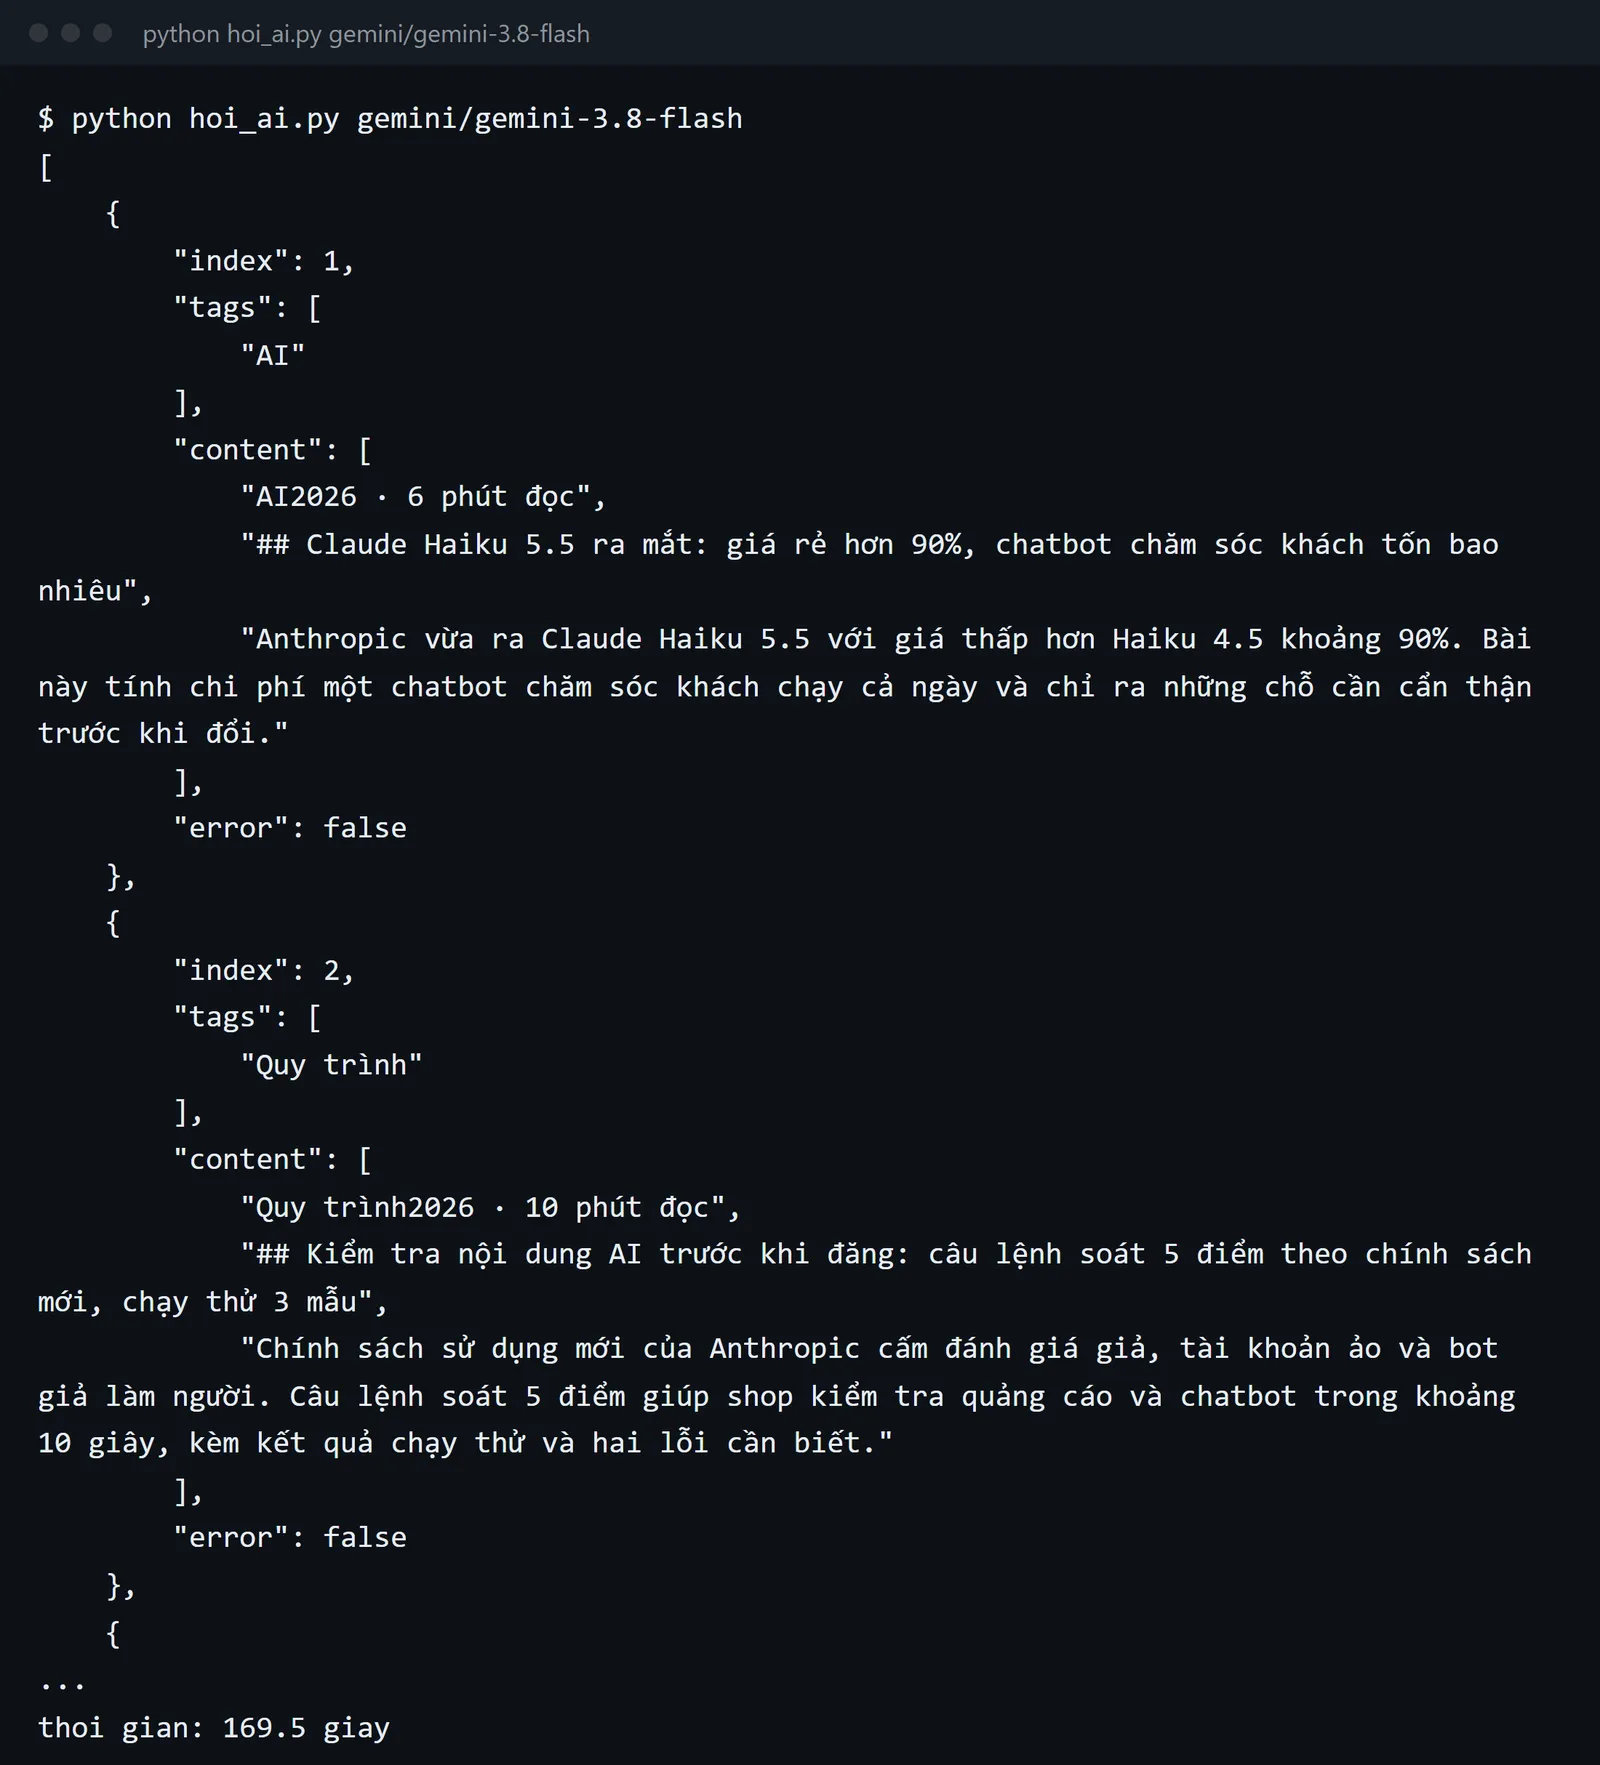
AI trả về từng khối có nhãn chủ đề (AI, Quy trình, Công cụ...), kèm tiêu đề và mô tả, nhưng ở chế độ "block" nó giữ nguyên đoạn văn chứ chưa tách thành từng trường gọn như cách CSS. Thời gian là 169,5 giây, gấp hơn 150 lần cách CSS trên cùng trang.
Bài học rút ra: AI hợp với trang mà bạn không muốn ngồi viết khuôn, hoặc cần hiểu nghĩa (ví dụ "đâu là giá sau giảm"). Còn trang cố định, theo dõi mỗi ngày thì dùng CSS cho nhanh và rẻ.
Ý nghĩa với người làm nội dung và bán hàng
Từ những gì đã chạy thử, đây là vài việc cụ thể bạn có thể làm:
- Thu thập dữ liệu đối thủ công khai mỗi sáng một cách tự động: tên sản phẩm, giá niêm yết, chương trình khuyến mãi trên website của họ, gom vào một bảng để so sánh, thay việc mở từng trang.
- Gom tin tức trong ngành từ vài trang báo thành một file Markdown, đưa AI xử lý và tóm tắt thành bản tin nội bộ 5 dòng, gửi tự động vào nhóm chat của đội.
- Lấy toàn bộ bài hướng dẫn, mô tả sản phẩm, câu hỏi thường gặp trên website của chính mình thành tài liệu sạch để nạp vào chatbot chăm sóc khách hàng, giúp chatbot trả lời đúng thông tin sản phẩm.
- Kiểm tra lại website của mình: danh sách bài, tiêu đề, link, xem trang nào thiếu mô tả để cải thiện thứ hạng tìm kiếm trên Google.
Nếu bạn đang muốn cho AI agent đọc web theo kiểu hỏi đâu lấy đó, mình từng chạy thử Agent-Reach cho AI agent đọc web, YouTube, RSS. Crawl4AI thì hợp hơn khi bạn cần lặp lại cùng một việc cào theo lịch. Những công cụ khác cùng nhóm có trong bài tổng hợp công cụ và mã nguồn đáng chú ý tuần này.
Tóm lại cách làm: viết khuôn CSS một lần cho trang cần theo dõi, để máy chạy mỗi sáng, chỉ gọi AI khi cần hiểu nghĩa hoặc tóm tắt.
Rủi ro cần biết trước khi dùng
Pháp lý và đạo đức. Chỉ cào trang công khai, đọc điều khoản sử dụng và tệp robots.txt của trang trước khi chạy, không thu thập dữ liệu cá nhân của khách hàng hay người dùng. Mình không tư vấn pháp lý; nếu dùng cho mục đích thương mại lớn, bạn nên hỏi người có chuyên môn. README có tính năng giả lập "không bị phát hiện" (Patchright), nhưng dùng nó để vượt rào chặn của trang khác là chuyện bạn cần cân nhắc kỹ.
Cần chút kỹ thuật. Bạn phải cài Python, gõ lệnh và sửa vài dòng code. Người không rành có thể nhờ AI viết đoạn khuôn CSS rồi chạy lại. Trang càng phức tạp, nhiều phần tải bằng JavaScript, thì càng cần cấu hình thêm như chờ phần tử hiện ra hoặc cuộn trang; README có cung cấp các tuỳ chọn này nhưng mình chưa thử.
Dễ hỏng theo thời gian. Trang đổi giao diện là khuôn CSS hỏng; tên model AI cũng thay đổi như lỗi 404 mình gặp. Cách xử lý là đặt kiểm tra đơn giản: nếu số dòng lấy được bằng 0 thì báo về để sửa.
Tài nguyên máy. Bộ cài tải khoảng 300 MB trình duyệt. README có nói chế độ chạy nhiều trang dùng bộ điều phối theo bộ nhớ; mình chưa thử chạy hàng trăm trang nên chưa có số liệu về RAM.
Kết luận
Crawl4AI là lựa chọn đáng thử nếu bạn muốn cào dữ liệu web bằng AI mà không trả phí theo lượt: cài khoảng 2 phút rưỡi, chuyển trang sang Markdown trong 9 giây, lấy bảng bằng CSS trong khoảng 1 giây.
Điểm cần nhớ là chia đúng việc cho đúng cách: trang cố định thì dùng khuôn CSS cho nhanh và không tốn tiền, trang khó hoặc cần hiểu nghĩa thì mới gọi AI và chấp nhận chờ lâu hơn.
Trước khi sử dụng cho việc kinh doanh, hãy đọc điều khoản của trang nguồn, chỉ lấy dữ liệu công khai và đặt một bước kiểm tra để biết khi nào khuôn bị hỏng. Nếu chưa rành code, bạn có thể bắt đầu bằng lệnh crwl để xem trang web biến thành văn bản sạch ra sao, rồi nhờ AI viết tiếp phần còn lại. Còn doanh nghiệp của các bạn đang phải làm đi làm lại việc gì mỗi ngày trên web, chép giá, gom tin hay theo dõi đối thủ? Hãy để lại bình luận dưới video trên fanpage Deman AI Lab, biết đâu đó là bài chạy thử tiếp theo của chúng mình khi cào dữ liệu web bằng AI.